
* 해당 글은 작성자의 복습을 위한 포스팅입니다
- 논문 링크: https://arxiv.org/pdf/1704.04861.pdf
- Github: https://github.com/tensorflow/models/blob/master/research/slim/nets/mobilenet_v1.md
$\mathscr{A}$ 문제제기
Convolutional Neural Network (CNN) 이 컴퓨터 비전 영역에서 활발하게 사용됨에 따라, 다양한 CNN 응용 모델들이 연구되고 발표되고 있다. 하지만, 실생활에 쓰이는 영역 (robotics, self-driving car, augmented reality etc.) 에서는 아직 방대한 Time & Computation Cost 이슈로 많은 한계점을 보이고 있다.
본 논문은 두개의 hyper-parameter를 사용하여 모바일 및 임베디드 어플리케이션을 위한 small size, low latency 모델을 만들고자 한다. MobileNet는 연산량과 파라미터 수를 줄임과 동시에 학습 및 추론 시간을 단축하는 데 큰 의의를 둘 수 있다.
$\mathscr{B}$ Method
MobileNet은 "Depthwise Separable Convolution" 라 칭하는 방법을 사용하는데, 이는 "Depthwise Covolution"과 "Pointwise Convotion"이라는 두가지두 가지 방법으로 이뤄져 있다. 논문에서는 이 두가지 방법을 매우 간략하게 소개하고 있는데, 나는 약간 더 자세히 설명해보고자 한다.
1. Depthwise Convolution
흔히 알고있는 일반적은 Convolution은 커널(필터)이 Input data의 channel과 Ouput data의 channel을 모두 건드리며 연산이 이뤄진다. 이와 달리 Depthwise Convolution은 커널의 각 channel들이 1:1로 매칭 되는 Input data의 channel과만 연산한다. 아래의 그림을 보면 쉽게 이해할 수 있다.
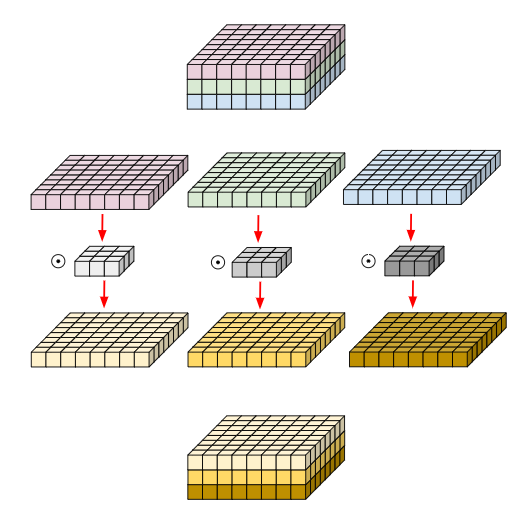
위 사진을 자세히 살펴보면 Input data의 사이즈는 $8 \times 8 \times 3$ (분홍색, 초록색, 하늘색) 이고, 이와 연산될 커널의 사이즈는 $3 \times 3 \times 3$ (흰색, 회색, 검은색) 다. 일반적인 Convolution이라면 Input data와 커널에 해당하는 모든 pixel들이 모두 연산되어야 하지만 Depthwise Convolution은 위 그림과 같이 각 매칭 되는 Channel 들끼리만 연산되는 것을 확인할 수 있다. 각 Channel의 Convolution 연산이 끝나면 각각의 Output을 하나로 합쳐 Output data로 뽑아낼 수 있다. 당연한 이야기지만, 각 Channel끼리 연산이 되기 때문에 Input data의 Channel 수와 Output data의 Channel 수는 동일할 수밖에 없다.
Depthwise Convolution을 다른 말로 표현하면, Input data의 Channel 방향은 고려하지 않고 공간 방향의 정보를 고려해 학습하는 과정이라 할 수 있다.
2. Pointwise Convolution
Pointwise Convolution은 Depthwise Convolution과 다르게 공간 방향의 정보를 고려하지 않고 Channel 방향만을 고려한 Convolution이다. Pointwise라는 단어는 $1 \times 1$ 크기의 커널을 사용하기 때문에 붙여졌다. 아래의 예시를 보자.
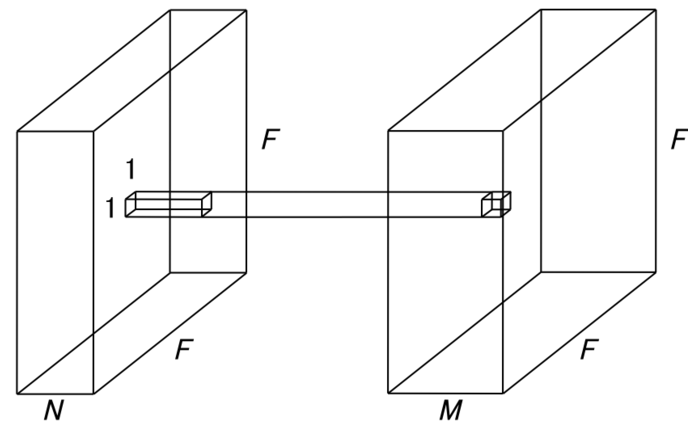
위 사진에서 Input data는 $F \times F \times N$ (F: Input의 높이와 너비, N: Input Channel 수) 의 크기를 가지고 있고 커널의 사이즈는 $1 \times 1 \times N \times M$ (M: Output Channel 수)이다. Pointwise Convolution은 Input의 정보를 $1 \times 1 \times N$ 사이즈의 커널을 사용해 1개의 pixel로 압축하는 효과를 내고 있다 (이해가 안 간다면 기본 Convolution의 연산에 대한 공부가 필요하다). 1개의 pixel이 M개가 쌓여 Output 사이즈는 자연스레 $F \times F \times M$ 이 된다. 즉, $1 \times 1$ 사이즈의 커널 연산을 통해 Channel의 개수만 변화를 준 것이다.
$1 \times 1$ 사이즈의 커널 연산은 다른 여러 모델에도 사용되는데, 주로 Channel 개수를 줄여 연산량과 파라미터 수를 줄이는데 사용된다. 하지만, Input data의 채널 수가 많을 경우에는 이 채널들을 1개의 pixel로 압축시키므로 정보 데이터가 대량 소실될 수 있는 문제가 생기기도 한다.
3. Depthwise Separable Convolution
본 논문에서 소개하고 있는 Depthwise Separable Convolution이 바로 위에서 소개한 두가지 방법을 연속적으로 연산하는 Convolution 방법이다. 아래 사진을 보면 쉽고 직관적으로 이해할 수 있다.
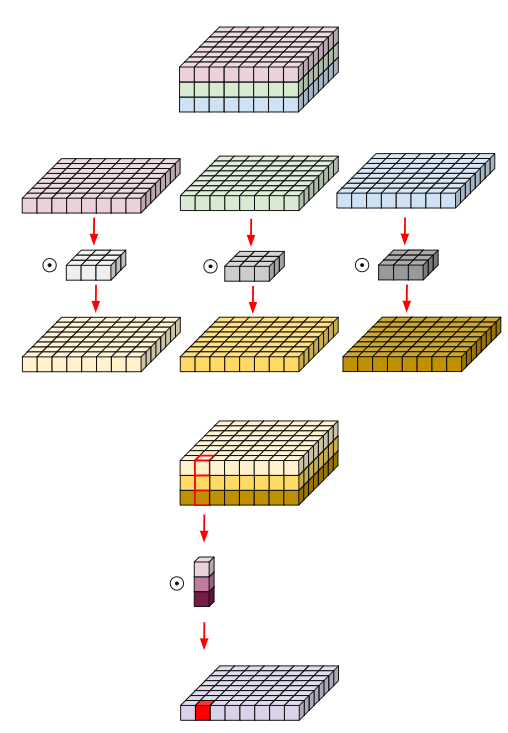
Depthwise Convolution을 설명할 때 사용했던 그림에 Pointwise Convolution 내용을 추가한 것이다. Depthwise Convolution을 통해 나온 Output에 Pointwise Convolution을 적용해 하나의 Channel로 압축하는 것을 확인할 수 있다. MobileNet은 이 방식을 사용해 기존 Convolution 보다 연상량과 파라미터 수를 줄일 수 있었고, 학습 및 추론 시간도 단축시킬 수 있었다.
4. Hyper Parameters
본 논문의 3.3, 3.4장에 등장하는 개념이다. MobilNet 네트워크의 Input 및 Output Channel의 개수와 Feature map의 사이즈를 조정 위한 width multiplier $\alpha$와 resolution multiplier $\rho$를 소개한다. 개인적으로 필요없는 내용을 있어 보이게(?) 만들기 위해 넣은 내용으로 느껴진다. 중요하지 않은 내용이다.
$\mathscr{C}$ Computational Cost
그럼 Depthwise Separable Convolution을 사용해 Computational Cost가 기존 Convolution에 비해 얼마나 줄어들었는지 확인해보자. 계산에 사용할 문자들은 다음과 같다.
$D_K$: 커널 높이 및 너비 사이즈, $D_F$: Feature map of Input사이즈, $M$: Input Channel, $N$: Output Channel
- Input data 사이즈: $D_F$ $\times$ $D_F$ $\times$ $M$
- 커널 사이즈: $D_K$ $\times$ $D_K$ $\times$ $M$ $\times$ $N$
1. Original Convolution
기존 Convolution 연산은 Input과 커널의 모든 pixel들이 사용된다 (꼭, 기본 Convolution의 연산과정을 손으로 풀어 공부하길 추천한다). 이때의 Convolutional Cost는 사용되는 모든 사이즈의 곱으로 표현된다.
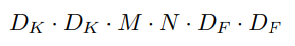
2. Depthwise Separable Convolution
Depthwise Separable Convolution은 Depthwise Convolution과 Pointwise Convolution이 연속적으로 연산되기 때문에 이 두 가지의 Cost를 더해주면 된다. 첫 번째로, Depthwise Convolutiond은 기존 Convolution과 다르게 공간 정보(M)만 고려한다. 즉, 각 채널끼리만 연산되기 때문에 Computational Cost는 다음과 같다
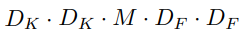
기존 Convolution과 다르게 Channel 정보인 N이 빠져있다. 다시 풀어 말하면, $D_F$ $\times$ $D_F$ $\times$ 1 사이즈의 Input과 $D_K$ $\times$ $D_K$ $\times$ 1 $\times$ $M$ 사이즈의 커널이 연산되는 것이다.
그 다음은 Pointwise Convolution이다. 위에서 언급했듯이, Depthwise Convolution이 계산된 후 그 Output에 Pointwise Convolution이 적용된다. 그럼 Pointwise Convolution의 Input 사이즈는 $D_F$ $\times$ $D_F$ $\times$ $M$ 이고, 커널 사이즈는 1 $\times$ 1 $\times$ $M$ $\times$ $N$ 이 된다. 이에 해당하는 Computational Cost는 다음과 같다.
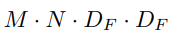
연속적으로 일어나는 이 두 Convolution의 Computational Cost는 단순히 더해주면 되므로, 최종적인 Depthwise Separable Convolution의 Computational Cost는 아래와 같다.
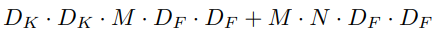
본 논문은 아래식과 같이 MobileNet의 연산량을 기존 Convolution과 비교했다. $3 \times 3$ 크기의 커널을 사용할 경우 약 8~9배의 연산량 감소 효과를 보인다.
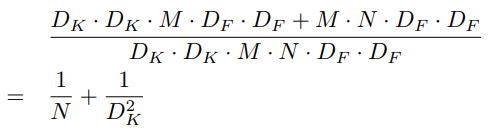
$\mathscr{D}$ Experiments
본 논문 저자들은 MobileNet의 성능을 시험해보고자 4가지의 Task에 적용해 다른 모델들의 결과와 비교했다. 그에 앞서 MobileNet 구조를 살펴보자.
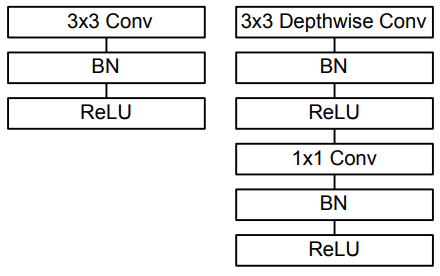
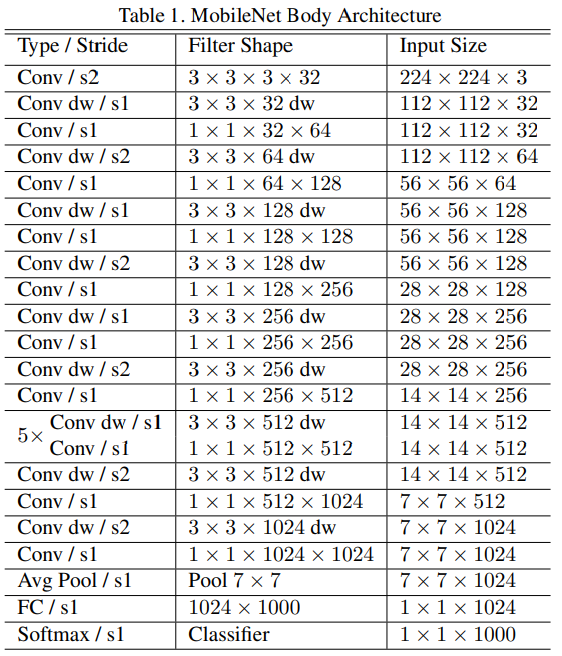
첫 번째 사진은 기존 Convolutiond을 Depthwise Separable Convolution으로 전환한 구조를 나타내며 Batch Normalization과 Activation Layer의 위치도 보여주고 있다. 실험에 사용한 전체 네트워크는 아래 Table과 같다.
본 논문에서는 MobileNet의 성능을 Fine Grained Recognition, Large Scale Geolocalization, Face Attributes, Object Detection, Face Embeddings 테스트에 적용해 다른 기존 모델들보다 작은 연상량 및 파라미터 수로 뒤처지지 않는 결과를 내고 있다고 길게 설명하고 있다. (자세한 결과는 논문 참고)
* 참고문헌